오늘은 기존에 AI Agent를 구축하려고 했던 분 혹은 Agent의 기억을 의미 있게 쌓으려는 것 관해서 시도하려는 분들에게 도움이 될 만한 내용입니다.
기억하고, 경험하고, 배우는 에이전트
나는 내일 어제의 너와 만난다 라는 영화를 보신적 있으신가요?
주인공은 상대 연인과 추억을 쌓으며 살아가지만 상대 연인은 나와의 추억은 없던 기억인 슬프지만 다시보고 싶은 영화이죠.
AI를 쓰다보면 이런 상황을 종종 맞이하게 됩니다.
새로운 세션이 시작되면 방금까지 좋았던 기억을 고스란히 잊어버리고 저를 반갑게 맞이합니다.
아니 아까 말한거 해달라니까?
Agent는 왜 매번 처음 일하는 사람처럼 행동할까요?
이전에 같은 문제를 해결한 적이 있어도 다시 처음부터 탐색하고, 같은 실수를 했어도 다음 실행에서 또 반복합니다.
우리가 ChatGPT나 Claude 같은 제품을 사용할 때는 내부 구조적으로 잘 만들어져 있어 체감이 안되지만, 직접 LLM API를 이용해 Agent를 만들기 시작하면 이 문제가 생각보다 크게 다가옵니다.
Agent를 처음 만들고자 할때에는 이를 해결하는 방법이 RAG나 Vector DB라고 생각하기 쉽습니다. 과거 대화나 문서를 embedding해서 저장하고, 현재 질문과 유사한 정보를 찾아 Context에 넣어주면 된다고 생각하는 것입니다.
하지만 Agent에게 필요한 기억은
- 지금 무엇을 하고 있는지 기억해야 하고
- 과거에 어떤 일을 했는지 기억해야 하며
- 무엇을 알고 있는지도 기억해야 합니다
- 그리고 더 나아가 과거 경험으로부터 앞으로 어떻게 행동해야 할지까지 배울 필요가 있습니다.
결국 Agent Memory는 저장소라기보다 하나의 학습 구조에 가깝다고 볼 수 있습니다.
사람도 모든 것을 한 번에 기억하지 않는다
사람이 일을 할 때를 생각해보면 조금 이해하기 쉽습니다.
코드를 수정하고 있다고 해보겠습니다.
지금 수정하고 있는 파일, 확인해야 할 변수, 다음에 실행할 테스트 같은 것은 잠깐 머릿속에 유지합니다.
이 함수 수정하고 → 테스트 실행하고 → 결과 확인해야지.
하지만 몇 달 전에 했던 모든 작업 내용을 동시에 떠올리고 있지는 않습니다.
인지과학 분야에서는 지금 사고와 작업에 필요한 정보를 일시적으로 유지하는 것 -> Working Memory라고 부릅니다.
이와 비슷한 역할을 하는 것은 Context Window입니다.
현재 대화, 현재 Task, Tool 결과, 현재 계획 등을 Context 안에 넣어두고 작업합니다.
문제는 Context Window 역시 무한하지 않다는 것입니다.
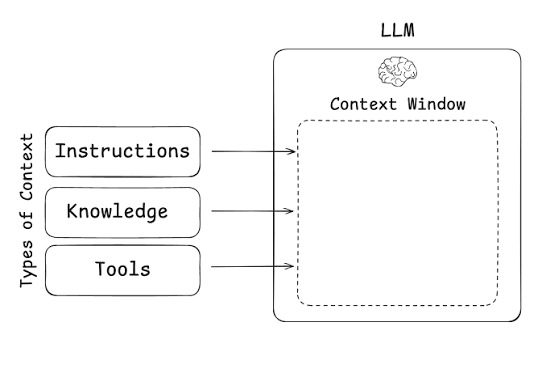
대화나 작업이 길어지면 Context가 가득 차고, 결국 오래된 내용을 제거하거나 요약해야 합니다. 이 과정에서 세부 정보가 사라질 수도 있습니다.
이 문제를 다룬 접근이 MemGPT입니다.
MemGPT는 LLM의 Context Window를 컴퓨터의 RAM처럼 바라봅니다.
Context Window
= 현재 필요한 Working Memory

External Memory
= 지금 당장 필요하지 않은 장기 기억
즉 모든 기억을 Context 안에 넣어두는 것이 아니라, 필요한 정보만 Context에 올리고 나머지는 외부 Memory에 저장합니다.
중요한 점은 단순히 저장소를 추가했다는 것이 아닙니다.
Agent가 스스로
이 정보는 앞으로도 필요하겠다.
→ 저장

지금 과거 정보가 필요하다.
→ 검색

기존 정보가 바뀌었다.
→ 수정
같은 행동을 할 수 있도록 Memory를 관리하는 Harness를 만든다는 점입니다.
이 관점에서 보면 RAG와 Agent Memory의 차이도 조금 선명해집니다.
RAG가 해결하려고 하는 문제가
현재 질문에 필요한 문서는 무엇인가?
라면 Agent Memory는
무엇을 기억해야 하고, 언제 다시 꺼내며, 기존 기억을 언제 수정해야 하는가?
까지 자동으로 문제를 포함하여 해결할 수 있습니다.
사건과 지식은 다르다
기억을 조금 더 자세히 보면 한 종류만 있는 것이 아닙니다.
간단한 퀴즈를 내볼게요
OO 은 대한민국의 수도다.
OO에 들어갈 말을 아시나요?
정답은 서울이죠.
이를 모든 우리가 아는 이유는 해당 문장은 사실과 지식이기 때문입니다.
그렇다면 아래 문장에서도 맞춰보실까요?
지난주 서울역에서 OO를 만났다.
정답은 친구였습니다.
이런 정답은 맞추기 쉽지 않습니다.
그 이유는 일반적인 지식이 아닌 개인의 경험이기 때문이죠.
이렇듯 지식에는 taxonomy, 분류체계가 존재합니다.
Agent Memory에서도 비슷하게 구분할 수 있습니다.
Working Memory
→ 지금 무엇을 하고 있는가

Episodic Memory
→ 과거에 무슨 일이 있었는가

Semantic Memory
→ 무엇을 알고 있는가

Procedural Memory
→ 어떻게 행동해야 하는가
예를 들어 코딩 Agent라면 다음과 같습니다.
Episodic Memory

지난번 serializer를 수정한 뒤
API schema regression이 발생했고,
response schema를 분리해서 해결했다.
이것은 하나의 경험입니다.
반면
Semantic Memory

이 프로젝트는 Django를 사용한다.
DB는 PostgreSQL이다.
Python 버전은 3.12다.
는 현재 알고 있는 사실에 가깝습니다.
그리고 여기서 더 흥미로운 것이 Procedural Memory입니다.
Procedural Memory

serializer를 수정하면
API schema regression test를 실행한다.
이것은 단순한 지식이라기보다 행동하는 방법입니다.
사람도 어떤 일을 반복하다 보면 사실을 기억하는 것을 넘어 -> 이럴 때는 이렇게 해야 한다는 요령을 갖게 됩니다.
Agent 역시 같은 방향으로 갈 수 있습니다.
경험이 쌓인다고 자동으로 배우는 것은 아니다
여기서 중요한 문제가 하나 생깁니다.
과거 경험을 많이 저장한다고 해서 Agent가 자동으로 더 똑똑해질까요?
그렇지는 않습니다.
예를 들어 다음 경험이 있다고 해보겠습니다.
서버 오류 발생
→ Redis 재시작
→ 서버 정상화
이 기록만 보면 Agent는
“서버 오류가 발생하면 Redis를 재시작하면 된다.”
라고 기억할 수도 있습니다.
하지만 실제 원인은 우연히 네트워크 상태가 회복된 것일 수도 있습니다.
즉 경험과 올바른 교훈은 다릅니다.
사람도 경험을 했다고 항상 올바른 교훈을 얻는 것은 아닙니다.
그래서 Agent에서도 단순히 Episode를 저장하는 것과, 그 Episode에서 무엇을 배울지를 구분할 필요가 있습니다.
이 지점에서 Memory와 Verifier가 연결됩니다.
Verifier가 Memory와 만나면 무엇이 달라지는가
보통 Verifier는 Agent의 결과를 평가하는 역할로 생각합니다.
Agent 실행
→ 결과
→ PASS / FAIL
하지만 여기서 끝나면 Agent는 다음 실행에서 같은 실수를 다시 할 수 있습니다.
반대로 Memory만 있다면 과거 경험은 많이 쌓이지만 어떤 경험이 중요한지 알기 어렵습니다.
둘을 연결하면 구조가 달라집니다.
Agent 실행
      ↓
Verifier
      ↓
왜 성공했는가?
왜 실패했는가?
      ↓
Episodic Memory
      ↓
여러 경험에서 공통점 발견
      ↓
Semantic / Procedural Memory
      ↓
다음 Planner에 반영
예를 들어 다음과 같은 실패가 반복됐다고 해보겠습니다.
Episode 1
API 변경
→ consumer 확인 누락
→ FAIL

Episode 2
Serializer 변경
→ contract test 누락
→ FAIL

Episode 3
Schema 변경
→ frontend 오류
→ FAIL
각각만 보면 서로 다른 문제처럼 보입니다.
하지만 여러 Episode를 함께 보면 공통점이 있습니다.
Observation

API boundary를 변경할 때
downstream 영향을 확인하지 않는 문제가 반복된다.
그리고 이것을 행동 규칙으로 일반화할 수 있습니다.
Procedural Memory

API contract 변경 전

1. downstream consumer 확인
2. schema diff 확인
3. contract test 실행
이제 다음 Task가 들어왔을 때 Planner는 이 규칙을 먼저 참고할 수 있습니다.
같은 Qwen, 같은 Claude, 같은 GPT를 사용하더라도 다음 실행에서 행동이 달라집니다.
과거의 평가 결과가 Memory를 바꾸고, 바뀐 Memory가 다시 Planner의 판단에 영향을 주기 때문입니다.
이런 의미에서 Verifier는 단순한 채점기가 아니라 Agent가 경험으로부터 무엇을 배워야 하는지를 결정하는 학습 신호가 될 수 있습니다.
기억은 저장되는 것이 아니라 정리되고 변화한다
최근 Agent Memory 연구가 재미있는 이유도 여기에 있습니다.
초기에는 주로 Vector DB에 과거 정보를 저장하고 유사도 검색을 수행했습니다.
최근에는 문제를 더 세분화해서 다룹니다.
Mem0
중요한 정보를 추출해서 Persistent Memory로 만들고, 기존 기억을 추가·수정·삭제하는 Memory Management에 초점을 둡니다.
A-MEM
제텔카스텐 방식에서 아이디어를 가져와 기억들을 독립된 노트처럼 관리하면서 서로 관계를 만들고, 새로운 기억이 들어오면 기존 기억의 의미까지 발전시키는 접근입니다.
HippoRAG
인간의 해마에서 영감을 받아, 단순히 비슷한 정보를 찾는 것이 아니라 Knowledge Graph의 관계를 따라 관련 정보를 검색합니다.
Graphiti/Zep
시간 개념까지 들어간 것
예를 들어
2025
Python 3.11 사용

2026
Python 3.12로 변경
이라고 했을 때
Python = 3.11을 그냥 삭제해버리는 것이 아니라,
Python 3.11
valid: 과거

Python 3.12
valid: 현재
처럼 관리합니다.
사람도 “지금은 아니지만 당시에는 그게 맞았다”라고 기억합니다.
Agent 역시 과거의 사실과 현재의 사실을 구분할 필요가 있습니다.
특히 과거 오류를 다시 참고해야 하는 경우라면 더욱 그렇습니다.
⭐️⭐️⭐️⭐️ Hindsight 기억에서 새로운 판단을 만든다 ⭐️⭐️⭐️⭐️
여러 접근 중 특히 흥미로웠던 것은 Hindsight였습니다.
제가 가고자 하는 방향과 가장 중요하다고 생각하는 차별점 포인트라고 생각이 들어서였는데요.
Hindsight의 핵심은 세 단어로 정리됩니다.
Retain
→ 기억한다

Recall
→ 기억을 꺼낸다

Reflect
→ 기억들을 보고 새로운 이해를 만든다
여기서 중요한 것은 마지막의 Reflect입니다.
단순히 과거 경험을 검색하는 것이 아니라 여러 경험을 보고 새로운 Observation과 Opinion을 만들어냅니다.
예를 들면:
Experience

serializer 변경 후 schema failure
DTO 변경 후 contract test failure
model 변경 후 frontend type mismatch

        ↓ Reflect

Observation

데이터 모델 경계가 변경될 때
API contract regression이 반복적으로 발생한다.

        ↓

Opinion / Rule

모델 변경 작업에서는
contract test를 우선 수행하는 것이 좋다.
이 구조는 앞서 이야기한 Verifier와 특히 잘 맞습니다.
Verifier가 각 실행의 성공/실패 원인과 근거를 만들어주고, Hindsight와 같은 Reflection 시스템이 여러 Episode를 종합하면 경험 → 관찰 → 행동 규칙이라는 흐름이 만들어집니다.
🧐 그렇다면 실제 Agent는 어떻게 만들 수 있을까?
현재 기준으로 모든 최신 Memory 연구를 한 번에 구현할 필요는 없어 보입니다.
오히려 역할을 분리하는 것이 중요합니다.
LangGraph / StateGraph
→ 현재 실행 흐름과 Working State 관리

Checkpointer
→ 현재 Task를 중단 후 다시 이어가기

Long-term Memory
→ Semantic / Episodic Memory 보존

Verifier
→ 실행 결과와 실패 원인 평가

Reflection
→ 여러 경험에서 Observation / Rule 추출

Planner
→ Memory를 다음 실행의 판단에 사용
예를 들어 Qwen 기반 Agent를 만든다면 다음과 같은 구조를 생각해볼 수 있습니다.
               User Task
                   ↓
                Planner
                   ↓
                Executor
                   ↓
                Verifier
                   ↓
        Structured Evaluation
                   ↓
            Episodic Memory
                   ↓
               Reflect
                   ↓
           Candidate Rule
                   ↓
             Rule Verify
                   ↓
          Procedural Memory
                   ↓
             Next Planner
여기에서 Mem0, LangMem, Hindsight, Graphiti 같은 기술을 목적에 따라 선택적으로 사용할 수 있습니다.
중요한 것은 특정 Memory Framework를 사용하는 것이 아니라 Memory가 Agent의 실행 루프 어디에 들어가는지 이해하는 것이라고 생각합니다.
Memory는 과거를 저장하기 위한 것이 아니다
처음 Agent Memory를 봤을 때는 단순히 Context Window가 부족하기 때문에 과거 대화를 Vector DB에 저장해두는 기술이라고 생각했습니다.
하지만 여러 접근을 살펴보니 Memory가 다루는 문제의 범위는 훨씬 넓었습니다.
무엇을 기억할 것인가

어떤 형태로 기억할 것인가

어떤 기억끼리 연결할 것인가

현재 사실과 과거 사실을 어떻게 구분할 것인가

과거 경험에서 무엇을 배울 것인가

배운 내용을 다음 행동에 어떻게 반영할 것인가
결국 Agent에게 Memory가 필요한 이유는 과거를 완벽하게 보존하기 위해서가 아닙니다.
과거의 경험이 현재의 판단을 바꾸게 하기 위해서입니다.
이 관점에서 보면 Memory와 Verifier의 관계도 명확해집니다.
Memory without Verifier
→ 경험은 많지만 무엇을 배워야 할지 모르는 Agent

Verifier without Memory
→ 잘못을 발견하지만 다음 실행에서 잊어버리는 Agent

Memory + Verifier
→ 평가된 경험이 다음 행동을 바꾸는 Agent

Memory + Verifier + Reflection
→ 경험으로부터 일반화하는 Agent
그리고 이 구조가 반복되면 Agent는 단순히 더 많은 정보를 가진 시스템을 넘어, 자신이 수행했던 일을 바탕으로 다음 행동을 조금씩 바꾸는 시스템이 됩니다.
아직 이것을 인간의 학습과 동일하다고 말할 수는 없겠지만, 적어도 엔지니어링 관점에서는 “스스로 개선되는 Agent”라는 모호했던 표현이 꽤 구체적인 구조로 바뀝니다.
Experience
→ Evaluation
→ Reflection
→ Memory
→ Better Action
앞으로 Agent를 설계할 때는 모델에게 얼마나 많은 정보를 넣을지만큼이나,
이 Agent가 일을 하면서 무엇을 경험으로 남기고, 그 경험에서 무엇을 배우게 할 것인가? 를 같이 고민해야 할 것 같습니다.
'AI공부' 카테고리의 다른 글
| LLM 이해하기 ( 기초편 ) (0) | 2026.10.03 |
|---|---|
| SI, AI (2) | 2026.08.21 |
| Termin AI ( feat. 개발자들의 집단 지성 ) (1) | 2026.01.16 |
| OpenCode 알아보기 (2) | 2026.01.11 |
| 클로드 코드 창시자의 클로드 코드 꿀팁 13가지 (0) | 2026.01.08 |
