LLM이 어떻게 만들어지고, 입력을 받았을 때 내부에서 무슨 일이 일어나는지는 알고 가는 게 좋을 것 같아 관련 영상을 하나 봤다.
https://www.youtube.com/watch?v=geY4UO23QA8
이번 글은 유튜브에 있는 내용 + 챗지피티랑 딥 다이브한 내용 정리를 할 예정이다.
LLM이란?
-> 거대한 신경망(Neural Network)이다.
신경망의 기본 구조는 생각보다 단순하다.
입력 (x)에 가중치 (W)를 곱하고 bias (b)를 더한다.
z=Wx+b
그리고 ReLU 같은 비선형 함수를 통과시킨다.
h=ReLU(z)
이걸 여러 층 반복한다.
x -> Layer_1 -> Layer_2 -> ... -> Layer_N -> output
왜 굳이 여러 층을 쌓을까?
1차 함수만 아무리 합성해도 결국 1차 함수이기 때문이다.
f(g(x))=ax+b
그래서 ReLU 같은 비선형 함수를 중간에 넣는다.
ReLU란?
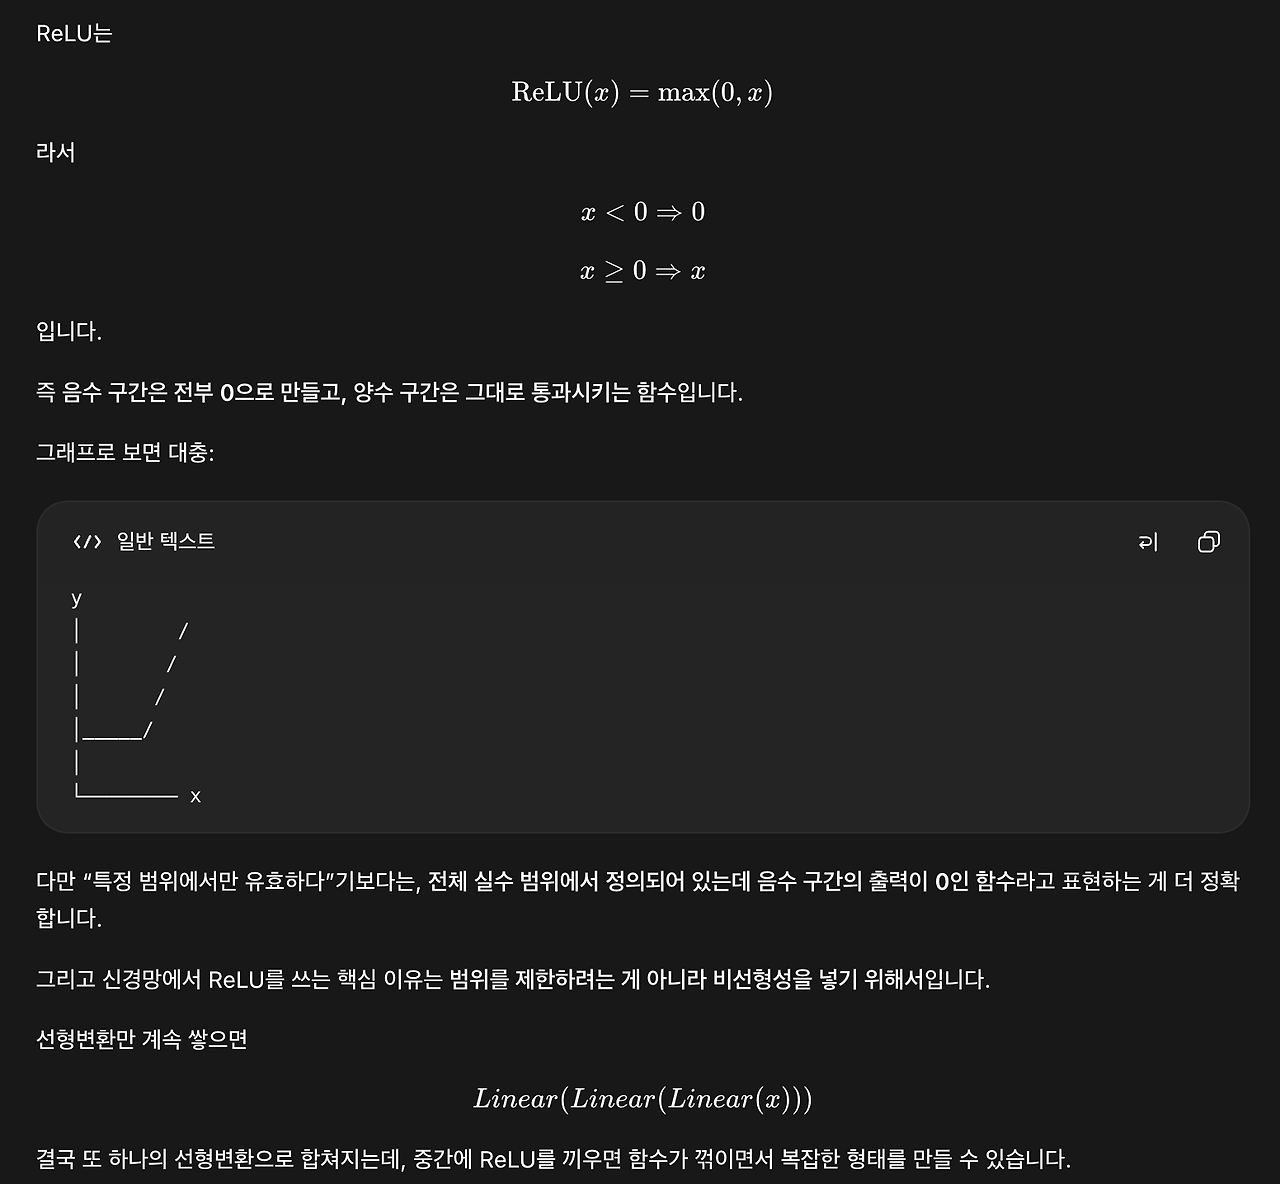
-> 뭔소리..?
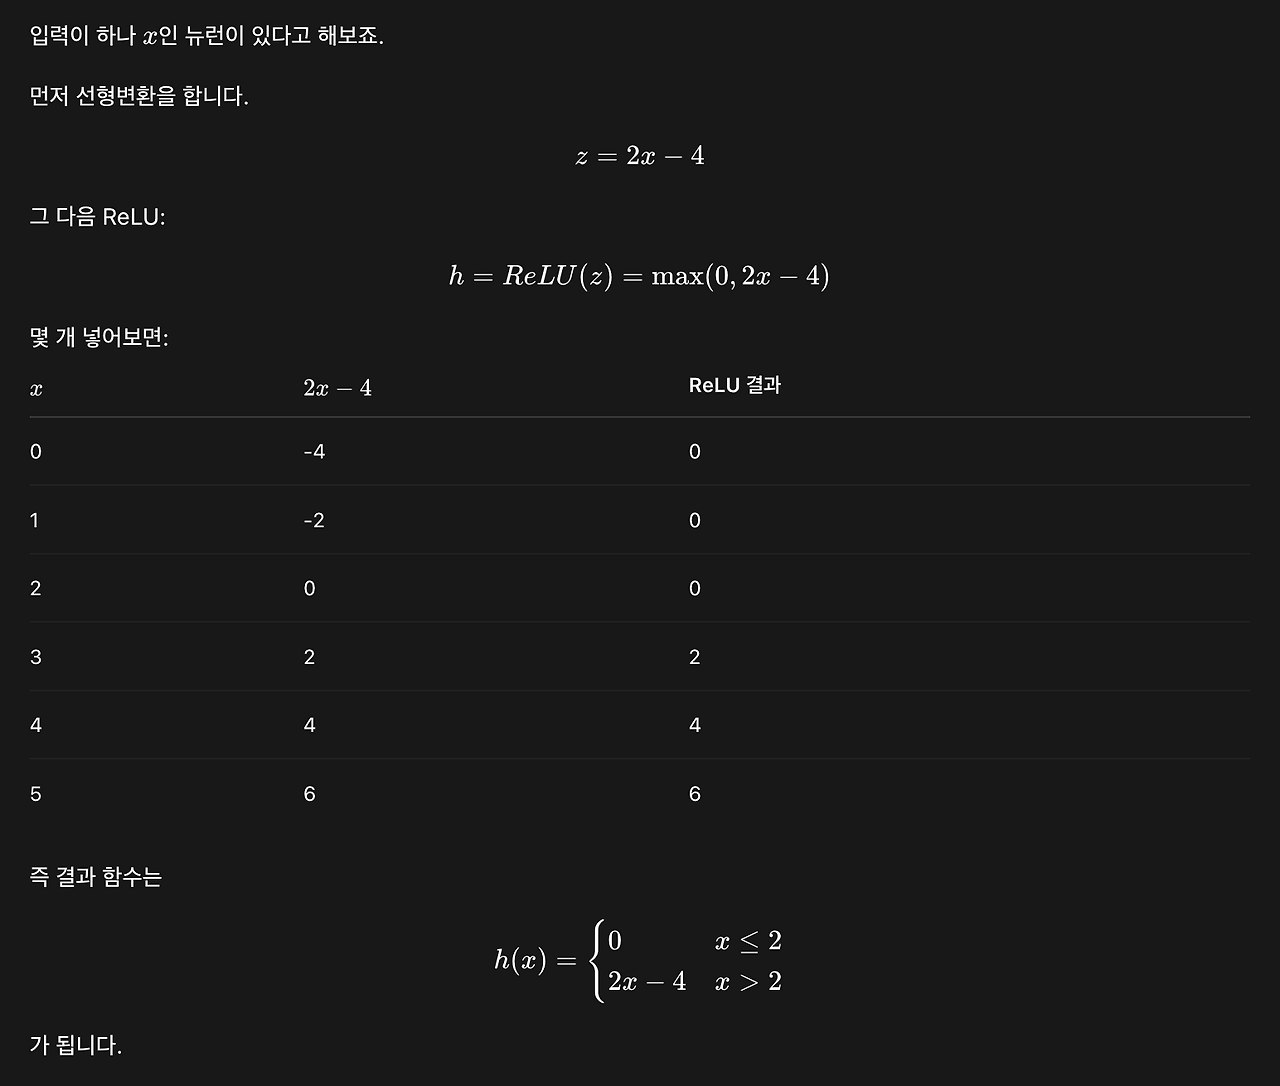
양의 범위에서만 살아남게 해준다
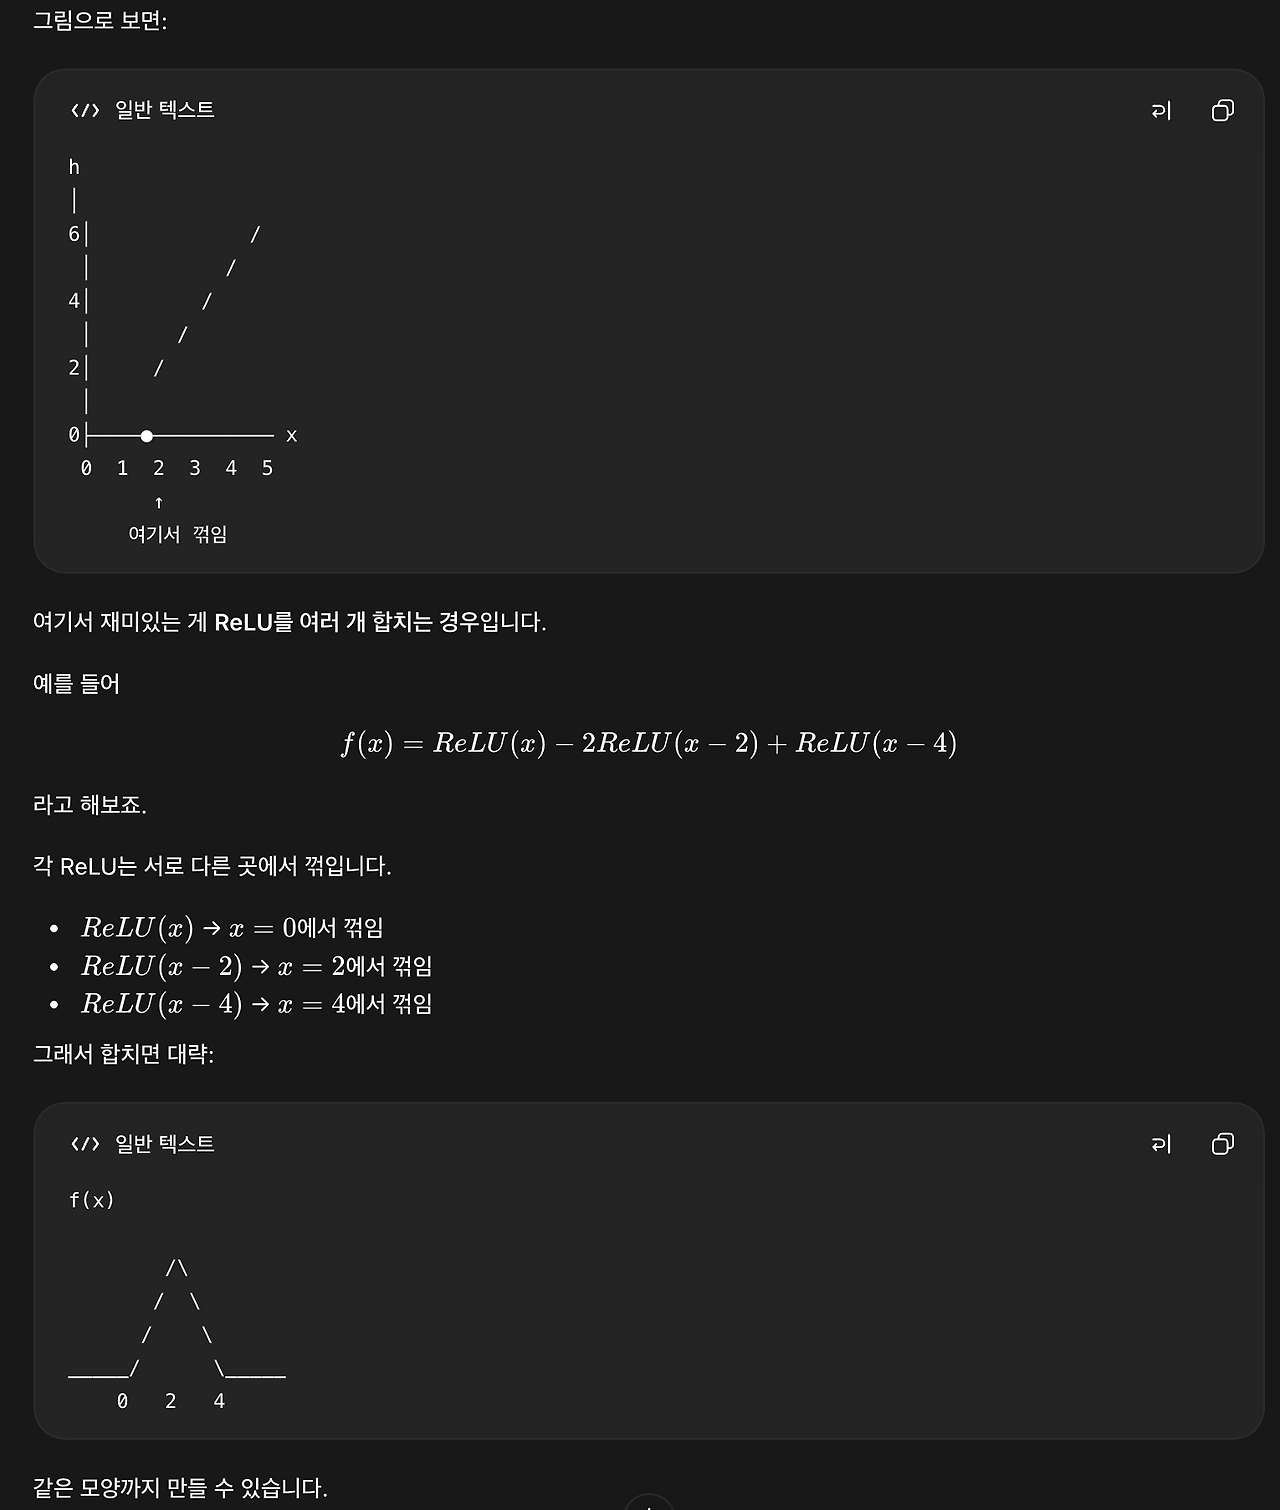
-> 즉, 이런식으로 선형 1차식 + 어떤 범위에서만 유효하게 하는 애를 조합하면 복잡한 그래프를 만들 수 있다.
이렇게 되면 신경망은 단순한 함수들을 조합해서 매우 복잡한 함수를 표현할 수 있게 된다.
딥러닝을 굉장히 거칠게 표현하면 결국,
복잡한 함수를 직접 설계하는 대신 단순한 함수들을 많이 쌓고, 데이터에 맞도록 그 함수의 모양을 학습시키는 방법
이라고 볼 수 있다.
LLM 모델 학습 과정
LLM이 해결해야 할 문제는 앞의 토큰들이 주어졌을 때 다음 토큰은 무엇일까?이다.
예를 들어
오늘 점심은 김치 ___
라는 입력을 보고 다음 토큰이 무엇일지 예측한다.
Vocabulary에 있는 모든 토큰에 대해 점수를 낸다.
예를 들어 vocabulary 크기가 100,000이라면 출력도 대략 100,000개의 점수가 된다.
이 점수를 logit이라고 한다. 이 logit을 softmax 함수를 적용하면 통과시키면 확률분포가 된다.
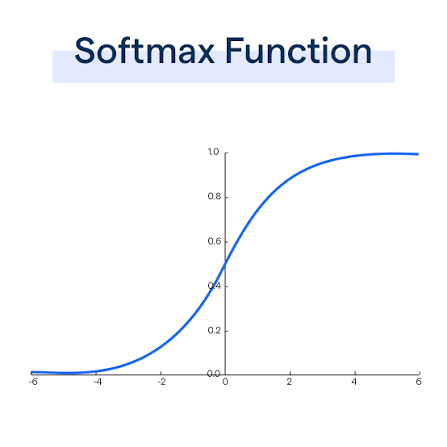
대충 이렇게 생겼다.
다 더하면 1이 되는 함수이다

예시가 역시 편할 것 같아 정리하면, 김치 ___ 뒤에는 볶음밥, 찌개, 피자탕수육(김피탕ㅋ) ... 등 여러 단어들이 올 수 있다.
이런 단어들이 오늘 점심은 김치 ___ 올 확률들을 나타낸 것이다.
결국 LLM은 매 순간 다음 토큰으로 무엇이 나올 확률이 가장 높은가? 를 계산하고 있는 것이다.
그러면 어떻게 다음 토큰 맞히기만 하는데 왜 코딩도 하고, 논리 문제도 풀고, 대화를 이어갈 수 있을까?
-> 이 이야기는 뒤에서 나온다.
3. Corpus, Sequence, Token, Vocabulary
용어정리를 해야하긴 하더라. 정확하게 잡자.
Corpus
Corpus(코퍼스)는 학습에 사용하는 거대한 텍스트 집합이다.
책, 문서, 코드, 웹 문서 등의 대규모 텍스트 데이터가 이에 해당한다.
단순하게 말하면
모델이 공부할 책 더미
라고 생각할 수 있다.
Sequence
순서가 있는 토큰들의 나열이다.
예를 들어
오늘 점심은 치킨이다
라는 문장이 tokenizer를 거쳐
[오늘] [점심] [은] [치킨] [이다]처럼 쪼개졌다고 하자.
그러면 이 토큰들의 순서 있는 배열이 하나의 sequence다.
실제로는 각 토큰에 ID가 있으므로
[17, 427, 1513, 13, 5]같은 숫자 배열이 된다.
Token !== 단어
한국어의 점심이라는 단어가 반드시 하나의 토큰이라는 보장은 없다.
Tokenizer에 따라서
점 + 심으로 나뉠 수도 있고 하나의 토큰일 수도 있다.
영어도 마찬가지다.
unbelievable이
un + believe + able같이 여러 토큰으로 나뉠 수 있다.
왜 이렇게 할까?
세상의 모든 단어를 vocabulary에 넣는 것은 불가능하기 때문이다.
그래서 자주 반복되는 문자/바이트 패턴을 적절한 단위로 합쳐 vocabulary를 만든다.
대표적으로 BPE(Byte Pair Encoding), Unigram 같은 tokenization 방식이 있다.
즉 대략적인 흐름은 아래와 같다.
Corpus
   ↓
Tokenizer 학습
   ↓
Vocabulary 생성
   ↓
텍스트 → Token IDs
여기서 하나 유의할 점이 코퍼스 자체가 vocabulary가 되는 것은 아니다.
코퍼스에서 tokenizer를 학습하고, tokenizer가 vocabulary를 만든 뒤, 그 tokenizer를 이용해 학습 데이터를 token sequence로 변환한다.
숫자 ID와 Embedding
토큰화가 끝나면 문장은 이런 식의 숫자 배열이 된다.
[17, 427, 1513, 13, 5]그런데 여기서 427이 17보다 큰 숫자라고 해서 의미적으로 더 크거나 중요한 건 아니다.
그냥 vocabulary 안에서 각 토큰을 구분하기 위한 ID일 뿐이다.
문제는 신경망 입장에서는 이런 단순한 ID만 가지고는 토큰 사이의 의미적인 관계를 다루기 어렵다는 점이다.
그래서 각 토큰 ID를 여러 개의 숫자로 이루어진 벡터로 바꾼다.
이게 Embedding이다.
예를 들어
token 17
→ [0.21, -0.17, 0.53, ...]
같은 형태다.
즉 하나의 토큰을 숫자 하나로 표현하는 게 아니라, 수백~수천 차원의 벡터로 표현한다.
이 벡터는 처음부터 "이 숫자는 명사, 이 숫자는 사람" 이런 식으로 의미가 박혀 있는 건 아니다.
학습하면서 다음 토큰을 더 잘 맞히는 방향으로 embedding도 같이 조정된다.
그래서 학습이 진행되면 토큰들이 고차원 공간 안에서 나름의 관계를 갖게 된다.
Transformer 구조
이제 embedding 벡터를 실제 신경망에 넣는다.
현대 LLM에서 가장 많이 사용되는 신경망 구조가 Transformer다.
2017년 Google 연구진이 발표한 Attention Is All You Need 논문에서 등장했다.
Transformer를 굉장히 단순화하면 이런 구조가 반복된다.
입력
 ↓
Attention
 ↓
MLP
 ↓
다음 Layer
실제로는 중간에 Layer Normalization, Residual Connection 같은 것들이 더 들어가지만 지금 단계에서는 일단 두 개만 잡아도 된다.
Attention
다른 토큰들의 정보를 가져오는 부분.
MLP
가져온 정보를 바탕으로 현재 토큰의 표현을 다시 가공하는 부분.
Attention = 토큰끼리 정보 교환
MLP = 각 토큰 내부 계산
일단은 이정도로 이해했다.
이 두 과정을 여러 층 반복하면서 각 토큰이 처음보다 훨씬 많은 문맥 정보를 가지게 된다.
Attention
예를 들어 이런 문장이 있다고 하자.
철수는 밥을 먹었다. 그는 배가 고팠다.
그라는 단어만 놓고 보면 누구를 말하는지 알 수 없다.
그런데 앞 문장을 같이 보면 철수를 가리킬 가능성이 높다는 걸 알 수 있다.
Transformer에서는 이런 관계를 계산하기 위해 Attention을 사용한다.
대충 이런 느낌이다.
그 → 철수      0.91
그 → 밥        0.02
그 → 먹었다    0.04
...
즉 그라는 토큰을 처리할 때 다른 토큰들을 각각 얼마나 참고할지 숫자로 나타낸다.
다만 여기서 0.91 같은 값이 모델 안에 영구적으로 저장되어 있는 건 아니다.
다른 문장이 들어오면 관계도 달라진다.
즉 Attention은
현재 문맥 안에서 토큰끼리 얼마나 관련 있는지 그때그때 계산하고, 그 비율만큼 다른 토큰의 정보를 가져오는 연산
정도로 이해하면 된다.
Query, Key, Value
Attention을 계산할 때 각 토큰에서는 세 종류의 벡터를 만든다.
- Query
- Key
- Value
처음 보면 이름 때문에 헷갈리는데 역할을 나누면 생각보다 단순하다.
Query
지금 내가 어떤 정보를 찾고 있는가?
Key
나는 어떤 정보와 관련 있는가?
Value
나를 참고하기로 했다면 실제로 가져갈 정보는 무엇인가?
예를 들어 그라는 토큰이 철수를 얼마나 참고해야 하는지 계산한다고 하자.
이때는
Query(그) · Key(철수)처럼 두 벡터의 내적을 계산한다.
값이 크면 현재 그가 찾고 있는 정보와 철수가 가진 정보가 잘 맞는다고 볼 수 있다.
여기서 재미있는 점이 하나 있다.
일반적인 내적은 두 벡터의 순서를 바꿔도 값이 같다.
a · b = b · a그런데 Attention에서
Query(그) · Key(철수)와
Query(철수) · Key(그)는 같은 값일 필요가 없다.
왜냐하면 Query와 Key는 원래 토큰 벡터에 서로 다른 Weight를 적용해서 만들기 때문이다.
즉,
그가 철수를 얼마나 참고하는가
와
철수가 그를 얼마나 참고하는가
를 서로 다르게 표현할 수 있다.
단순히 두 단어가 얼마나 비슷한지만 보는 것이 아니라, 방향이 있는 관계까지 표현할 수 있는 셈이다.
Attention 수식의 의미
Attention은 크게 네 단계로 생각하면 편하다.
Query와 Key 비교
        ↓
관계 점수 계산
        ↓
Softmax
        ↓
Value를 비율에 맞게 가져오기
먼저 Query와 Key를 내적해서 토큰 사이의 관계 점수를 만든다.
예를 들어 이런 값이 나올 수 있다.
철수      4.2
밥        1.3
먹었다    0.2
그런데 이 숫자를 그대로 "얼마나 참고할지"에 사용하기는 애매하다.
그래서 Softmax를 사용한다.
철수      0.94
밥        0.05
먹었다    0.01
이제 전체 합이 1이 되는 참고 비율이 만들어졌다.
그다음 이 비율만큼 각 토큰의 Value를 가져와 섞는다.
즉 Attention은 아주 거칠게 말하면
Query와 Key로 어디를 볼지 결정하고, Value에서 실제 정보를 가져오는 과정
이라고 볼 수 있다.
Attention 공식에서 중간에 벡터 차원의 제곱근으로 나누는 부분도 있는데, 이는 내적값이 너무 커지지 않도록 크기를 조절하기 위한 것이다.
벡터 차원이 커질수록 내적 결과도 커지는 경향이 있고, 그 상태에서 Softmax를 적용하면 특정 토큰 하나에 값이 지나치게 몰릴 수 있기 때문이다.
지금 단계에서는
Attention 점수의 크기를 적당하게 맞춰주는 보정
정도로 이해해도 충분하다.
Attention의 연산량
Attention의 단점 중 하나는 계산량이다.
토큰이 여러 개 있으면 각 토큰이 다른 토큰들과의 관계를 계산한다.
예를 들어 토큰이 4개라면 대략 이런 관계가 생긴다.
토큰1 → 토큰1, 토큰2, 토큰3, 토큰4
토큰2 → 토큰1, 토큰2, 토큰3, 토큰4
토큰3 → 토큰1, 토큰2, 토큰3, 토큰4
토큰4 → 토큰1, 토큰2, 토큰3, 토큰4
즉 토큰이 n개라면 관계의 개수는 대략 n의 제곱으로 증가한다.
예를 들어
1,000 tokens  → 약 1,000,000개의 관계
10,000 tokens → 약 100,000,000개의 관계
가 된다.
그래서 Context Window가 길어질수록 Attention 계산량과 메모리 사용량이 빠르게 증가한다.
Multi-Head Attention
Attention 하나만으로 모든 관계를 표현할 필요는 없다.
그래서 Transformer에서는 Attention을 여러 개 병렬로 돌린다.
이게 Multi-Head Attention이다.
각 Head는 서로 다른 Query, Key, Value를 만드는 Weight를 가진다.
즉 같은 문장을 여러 관점에서 보는 셈이다.
예를 들어 어떤 Head는 가까운 단어끼리의 관계에 민감할 수도 있고,
다른 Head는 멀리 떨어진 토큰 사이의 관계를 중요하게 볼 수도 있다.
또 어떤 Head는 사람이 봐도 정확히 어떤 역할인지 설명하기 어려울 수도 있다.
중요한 점은 사람이
"1번 Head는 주어 담당"
처럼 역할을 직접 정해주는 게 아니라는 것이다.
학습 과정에서 각 Head의 Weight가 서로 다르게 조정되면서 자연스럽게 다른 패턴을 보게 된다.
Hidden State와 문맥
처음 Embedding 단계에서 철수라는 토큰은 주로 철수 자체에 대한 정보를 가진다.
그런데 Transformer Layer를 계속 지나면서 상황이 달라진다.
Attention을 통해 다른 토큰의 정보가 계속 들어오기 때문이다.
예를 들어 처음에는 그냥
철수에 가까운 표현이었다면,
여러 Layer를 지난 뒤에는
현재 문장에서
밥을 먹었고
뒤의 '그'가 가리키고 있는
철수
같은 문맥 정보가 반영된 표현으로 바뀔 수 있다.
이렇게 각 Layer에서 만들어지는 내부 벡터를 Hidden State라고 한다.
같은 그라는 토큰이라도
철수는 밥을 먹었다. 그는 배가 고팠다.와
영희는 집에 갔다. 그는 학교에 남았다.에서는 주변 문맥이 다르기 때문에 Hidden State도 다르게 만들어진다.
Transformer가 문맥을 처리할 수 있는 이유 중 하나다.
학습과 Weight
Transformer의 구조를 만들었다고 바로 좋은 결과가 나오는 것은 아니다.
처음에는 모델 안의 수많은 Weight가 제대로 된 값이 아니다.
그래서 학습 데이터를 넣고 결과를 한번 만들어본다.
입력
 ↓
Transformer
 ↓
다음 토큰 예측
그리고 실제 정답과 비교해서 얼마나 틀렸는지 계산한다.
이 값이 Loss다.
그다음 각 Weight가 이 Loss에 얼마나 영향을 줬는지를 계산한다.
여기서 사용하는 것이 Backpropagation, 역전파다.
역전파를 굉장히 단순하게 표현하면
최종적으로 얼마나 틀렸는지를 기준으로, 각 Weight가 그 오차에 얼마나 영향을 줬는지 뒤에서부터 계산하는 과정
이다.
뭐 대충 이런거 아닐까 싶기도 하고?
암튼, 그 결과를 바탕으로 Weight를 조금씩 수정한다.
예측
 ↓
Loss 계산
 ↓
Backpropagation
 ↓
Weight 수정
 ↓
다시 예측
이걸 반복한다.
모델을 학습시킨다 = 수십억 개의 Weight를 조금씩 계속 수정한다
Forward와 Backpropagation
처음에는 이 둘이 조금 헷갈렸다.
Transformer가 추론할 때
Layer 1
 ↓
Layer 2
 ↓
Layer 3
으로 값이 전달되는 것은 Forward Propagation이다.
현재 가지고 있는 Weight로 입력에서 출력까지 계산하는 과정이다.
반면 Backpropagation은 학습할 때 사용한다.
최종 Loss를 기준으로 각 Weight를 얼마나 수정해야 하는지 계산한다.
즉 학습이 끝난 LLM을 실제로 사용할 때는 일반적으로 Backpropagation을 하지 않는다.
그냥 현재 Weight를 가지고 Forward 계산만 한다.
Pretraining
LLM의 첫 번째 큰 학습 단계가 Pretraining이다.
대규모 Corpus를 토큰화해서 모델에 계속 넣고,
앞의 토큰들이 주어졌을 때 다음 토큰은 무엇인가?
를 반복해서 맞힌다.
틀리면 Loss를 계산하고, Backpropagation을 통해 Weight를 수정한다.
이 과정을 엄청나게 반복한다.
그 결과 언어 패턴, 코드, 여러 종류의 관계와 지식이 Weight에 반영된다.
이 단계가 끝난 모델을 보통 Base Model이라고 한다.
그런데 Base Model이 문장을 잘 이어 쓰는 것과 우리가 기대하는 "좋은 챗봇"은 조금 다른 문제다.
질문에 제대로 답하거나, 사용자의 지시를 잘 따르거나, 적절한 형식으로 답하는 능력은 추가 학습이 필요할 수 있다.
유튜브에서는 TPO를 맞춘다라고 하는데, Base Model은 좀 눈치없는 애인 거 같기도하다
Post-training
Pretraining 이후 모델의 행동을 실제 사용 목적에 맞게 조정하는 과정을 Post-training이라고 한다.
대표적으로 SFT와 Preference Optimization이 있다.
SFT
Supervised Fine-Tuning.
좋은 질문과 좋은 답변 예시를 보여주면서
이런 질문에는 이런 식으로 답하면 된다
를 추가로 학습한다.
Preference Optimization
여러 답변 중
A보다 B가 더 좋은 답변이다
같은 선호 정보를 이용해 모델을 조정한다.
RLHF나 DPO 같은 방식들이 이쪽과 관련 있다.
전체적인 흐름은 대략 이렇다.
Pretraining
     ↓
Base Model
     ↓
Post-training
     ↓
Assistant / Chat Model
같은 Transformer 구조를 사용하는 모델이라도 어떤 데이터로 어떻게 Post-training했느냐에 따라 실제 대화 느낌이 꽤 달라질 수 있다.
그래서 사실 ChatGpt랑 Claude Code랑 글 써놓은거 보면 ChatGpt가 훨씬 더 잘 쓴 거 같은 느낌을 받는데 이런 차이가 있지 않을까 싶다 ( 코드는 클로드가 훨씬 잘 씀 )
Benchmark
Benchmark는 학습 방법이 아니라 평가 방법이다.
모델에게 일종의 시험을 보는 것이다.
수학, 코딩, 추론, 지식 등 여러 종류의 문제를 풀게 하고 점수를 측정한다.
학습
 ↓
모델
 ↓
Benchmark
 ↓
성능 평가
어떤 모델은 코딩에서 강하고, 다른 모델은 수학이나 특정 언어에서 더 강할 수 있다.
그래서 Benchmark 하나의 숫자만 보고 모델 전체 능력을 판단하기는 어렵다.
LLM 추론 과정
학습이 끝난 모델에 실제 Prompt를 넣어보자.
예를 들어
오늘 점심 메뉴는
이라는 문장이 들어온다.
먼저 Tokenizer가 문장을 Token ID로 바꾼다.
[17, 427, 1513, 13, 5]그다음 Embedding을 거쳐 벡터가 된다.
이 벡터들이 Transformer Layer를 계속 통과한다.
Token IDs
 ↓
Embedding
 ↓
Transformer Layer
 ↓
Transformer Layer
 ↓
...
 ↓
Logits
마지막에는 Vocabulary에 있는 모든 Token 후보에 대한 점수가 나온다.
Logit과 Sampling
예를 들어 다음 Token 후보의 점수가 이런 식으로 나왔다고 하자.
찌개      8.2
볶음밥    7.8
라면      6.1
자동차   -2.4
이 점수가 Logit이다.
아직 확률은 아니다.
Softmax를 적용하면 확률처럼 해석할 수 있는 값으로 바뀐다.
찌개      0.52
볶음밥    0.35
라면      0.12
자동차    0.01
그다음 실제로 어떤 Token을 선택할지 결정한다.
무조건 가장 높은 값 하나만 고를 수도 있지만, 실제 생성형 LLM에서는 여러 Sampling 방법을 사용할 수 있다.
대표적으로
- Temperature
- Top-k
- Top-p
등이 있다.
그래서 같은 Prompt를 넣어도 항상 완전히 같은 답이 나오지는 않을 수 있다.
전체 흐름은
Logit
 ↓
Softmax
 ↓
확률분포
 ↓
Sampling
 ↓
다음 Token
정도로 볼 수 있다.
Prefill과 Decode
LLM 추론은 크게 Prefill과 Decode 두 단계로 나눠볼 수 있다.
Prompt에는 보통 이미 많은 Token이 들어 있다.
오늘 날씨가 좋아서 점심을 먹으러...이 Prompt 전체를 먼저 처리하는 단계가 Prefill이다.
이때 Prompt 안의 Token들에 대한 Attention 계산도 같이 진행된다.
그다음 새로운 Token을 하나씩 생성한다.
이 단계가 Decode다.
Prompt
 ↓
Prefill
 ↓
새 Token 생성
 ↓
Decode
 ↓
새 Token 생성
 ↓
Decode
 ↓
...
그래서 첫 번째 Token이 나오기까지 걸리는 시간과 그 이후 Token들이 생성되는 속도가 서로 다르게 느껴질 수 있다.
KV Cache
새로운 Token을 생성할 때마다 과거 Token들의 Key와 Value를 처음부터 다시 계산하면 낭비가 크다.
이미 전에 계산했기 때문이다.
그래서 과거 Token의 Key와 Value를 저장해둔다.
이게 KV Cache다.
새 Token이 들어오면 새 Query를 만들고,
기존에 저장해둔 Key들과 비교한다.
새 Query
 ↓
과거 Key들
 ↓
Attention 계산
 ↓
과거 Value에서 정보 가져오기
왜 Query는 저장하지 않을까?
-> Query는 해당 Token이 그 순간 무엇을 찾을지 계산할 때 사용한다.
즉, 과거 Token의 Query는 이미 역할이 끝난 셈이다.
반대로 Key와 Value는 앞으로 생성될 Token들이 계속 참고할 수 있다.
그래서 KV Cache라고 부른다.
Context가 길어질수록 저장해야 할 Key와 Value도 많아지기 때문에 메모리 사용량도 증가한다.
trade off 를 고려해야 할듯싶다,
Next Token Prediction과 추론
여기까지 보고 가장 궁금했던 부분이 이것이었다.
결국 다음 Token을 맞히는 모델인데 왜 논리 문제까지 풀 수 있는 걸까?
LLM의 기본 학습 목표는 다음 Token을 잘 맞히는 것이다.
그런데 다음 Token을 아주 잘 맞히려면 단순히 단어가 자주 같이 나왔다는 정보만으로는 부족하다.
예를 들어
컵을 탁자 끝으로 밀었다. 컵은 바닥으로 ___
에서 떨어졌다를 잘 예측하려면
- 컵은 물체라는 것
- 탁자가 컵을 받치고 있다는 것
- 탁자 밖으로 나가면 아래로 떨어질 수 있다는 것
같은 관계를 어느 정도 표현하는 것이 유리하다.
즉 다음 Token 예측을 잘하려다 보니, 그 과정에서 여러 개념과 관계를 내부 표현으로 학습하게 된다.
이런 관점이 Representation Learning이다.
문맥과 논리
예전에 ChatGPT와 얘기하다가 재미있었던 예시가 있었다.
A > B
B > C
라고 하면 보통
A > C라고 생각할 수 있다.
그런데 >가 단순한 크기 비교가 아니라 가위바위보에서 "이긴다"라는 뜻이라면 얘기가 달라진다.
가위 > 보
보 > 바위
라고 해도
가위 > 바위는 아니다.
오히려 바위가 가위를 이긴다.
즉 같은 기호라도 현재 문맥에서 어떤 관계를 의미하는지가 중요하다.
Transformer는 Layer를 지나면서 주변 Token의 정보를 Hidden State에 계속 반영한다.
그래서 같은 단어나 같은 기호도 Context에 따라 다르게 처리할 수 있다.
다만 모델 내부에서 정확히 어떤 계산 구조가 만들어져서 이런 논리를 처리하는지는 아직 완전히 해석된 것은 아니라고 한다.
( 이거 만든 사람도 모른다고 한다. )
Chain of Thought
긴 문제를 풀 때 중간 과정을 생성하는 것도 추론에 영향을 준다.
예를 들어 모델이
A는 B보다 크다.
B는 C보다 크다.
따라서...
까지 생성했다고 하자.
그다음 Token을 만들 때는 처음 Prompt만 보는 것이 아니다.
자기가 방금 생성한 문장도 Context에 들어간다.
기존 Context
 ↓
중간 결과 생성
 ↓
중간 결과가 Context에 추가
 ↓
다음 계산
그래서 생성한 중간 내용이 다음 계산을 위한 일종의 작업 공간 역할을 할 수 있다.
다만 제품에서 보여주는 reasoning 문장이 Transformer 내부의 모든 계산 과정을 그대로 보여주는 것은 아니다.
실제 내부에서는 Attention, MLP, Hidden State 같은 계산이 별도로 계속 일어난다.
하지만 Chain of Thought는 개발하다보면 꽤 중요한 디버깅 지표라 익숙했다.
LLM Agent
여기까지 오면 Agent도 생각보다 낯선 개념은 아니다.
일반적인 LLM은
Context
 ↓
LLM
 ↓
Text
를 만든다.
Agent는 Text뿐 아니라 Action도 선택할 수 있다.
예를 들어 코딩 Agent라면
현재 상태
 ↓
LLM
 ↓
다음 Action
 ├─ 파일 검색
 ├─ 파일 읽기
 ├─ 코드 수정
 ├─ 테스트 실행
 └─ 답변
같은 구조가 된다.
Tool을 실행해서 나온 결과는 다시 Context에 들어간다.
현재 상태
 ↓
판단
 ↓
Action
 ↓
Tool 실행
 ↓
결과
 ↓
새로운 상태
 ↓
다시 판단
그래서 Agent를 아주 거칠게 표현하면
LLM + Tools + State + Loop + Feedback이라고 볼 수 있다.
LLM이 한 번 답하고 끝나는 것이 아니라, 환경에서 나온 결과를 다시 받고 다음 행동을 이어간다는 점이 핵심이다.
Prompt, RAG, Fine-tuning
이 세 가지는 비슷하게 느껴질 수 있지만 해결하려는 문제가 다르다.
Prompt
현재 요청에서 모델에게 필요한 조건과 행동 방식을 전달한다.
예를 들어
당신은 제조 데이터 분석가다.
센서 데이터를 분석하고
이상 징후와 근거를 JSON으로 출력하라.
같은 형태다.
즉 현재 Context에 지침을 넣는 것이다.
RAG
RAG는 모델 바깥에 있는 정보를 검색해서 Context에 추가한다.
예를 들어 사내 문서가 10만 개 있는데 특정 장비에 대해 질문했다고 하자.
관련 문서를 먼저 찾고
사용자 질문
+
관련 문서
를 LLM에 넣는다.
내가 처음 잘못 이해했던 부분이 하나 있었다.
RAG는 필요한 Attention만 골라내는 방식이 아니다.
조금 더 정확하게는
Transformer가 읽을 정보 자체를 바깥에서 먼저 골라주는 방식
에 가깝다.
그래서 사내 문서, 고객별 문서, 최신 정보, 출처가 필요한 답변 같은 상황에서 많이 사용한다.
Fine-tuning
Fine-tuning은 모델의 Weight 자체를 추가 학습으로 바꾼다.
특정 형태의 출력을 반복해서 만들거나 특정 Task에 더 잘 맞도록 모델 자체를 조정할 때 사용할 수 있다.
반복적인 형식 / 행동이나 특화 task , 비용 최적화 등에 사용된다.
정리하면
Prompt
→ 현재 요청의 지침 전달

RAG
→ 외부 지식 추가

Fine-tuning
→ 모델 Weight 자체 변경
실제 서비스에서는 셋을 같이 사용하는 경우도 많다.
=> AX를 다루는 기업이 된다고 하면 이러한 문제를 정의하는 것도 중요할 뿐더러, 어떤 문제 해결 방법이 있는지 아는것도 중요하다.
전체 흐름
학습
Corpus
 ↓
Tokenizer
 ↓
Token Sequence
 ↓
Embedding
 ↓
Transformer
 ↓
Next Token Prediction
 ↓
Loss
 ↓
Backpropagation
 ↓
Weight Update
 ↓
Base Model
 ↓
Post-training
 ↓
LLM
추론
Prompt
 ↓
Tokenizer
 ↓
Token IDs
 ↓
Embedding
 ↓
Transformer
 ↓
Logits
 ↓
Softmax
 ↓
Sampling
 ↓
Next Token
 ↓
Context에 추가
 ↓
반복
Agent
Context
 ↓
LLM
 ↓
Action
 ↓
Tool
 ↓
결과
 ↓
Context 업데이트
 ↓
LLM
 ↓
반복
처음에는 하나하나가 전부 새로운 용어처럼 느껴졌는데 연결해보니 결국 같은 흐름 위에 있었다.
신경망이 있고,
그 신경망 구조 중 하나가 Transformer고,
Transformer를 대규모로 학습한 것이 LLM이고,
LLM에 Tool과 반복 실행 구조를 붙이면 Agent가 된다.
마치며
LLM을 처음 보면 온갖 용어가 붙어 있어서 굉장히 복잡한 무언가처럼 느껴진다.
하나씩 보다보니 예전에 배웠던 내용들이거나 현업에서 마주한 적이 있던거 같다.
신경망 구조 중 하나로 Transformer가 있고, Transformer를 엄청난 양의 데이터로 학습하면 LLM이 된다.
그리고 LLM에 Tool과 반복적인 Feedback Loop를 붙이면 Agent가 된다.
이제는 LLM이 입력을 받으면 내부에서 대충 어떤 일이 일어나는지 정도는 이전보다 훨씬 선명하게 설명할 수 있게 된거같다.
P.S. 처음부터 다시 읽어보니 글 쓰다가 ChatGPT랑 얘기하고, 다시 쓰고, 사진 넣고를 반복하다 보니 전체 맥락이 좀 꼬인 것 같다. Attention이 여기저기 튄 결과랄까 ㅋㅋ .. 언젠가 Context를 다시 정리할 날이 오면 한 번 제대로 손봐야겠다.
'AI공부' 카테고리의 다른 글
| Memory With Agent (0) | 2026.10.03 |
|---|---|
| SI, AI (2) | 2026.08.21 |
| Termin AI ( feat. 개발자들의 집단 지성 ) (1) | 2026.01.16 |
| OpenCode 알아보기 (2) | 2026.01.11 |
| 클로드 코드 창시자의 클로드 코드 꿀팁 13가지 (0) | 2026.01.08 |
